用树莓派打造ChatGPT智能音箱
GPTSpeaker:唤醒词 + Azure语音 + ChatGPT/DeepSeek
用树莓派打造ChatGPT智能音箱
题记
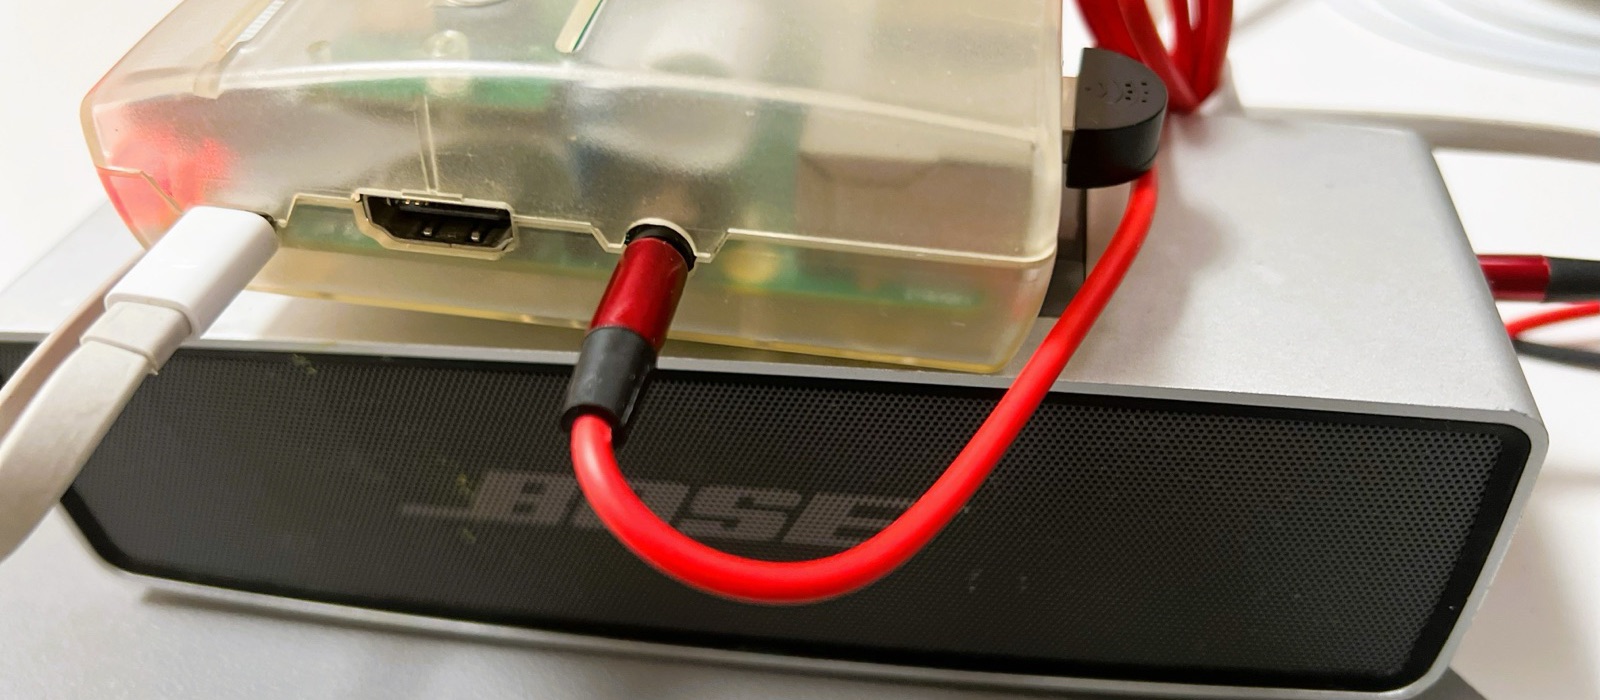
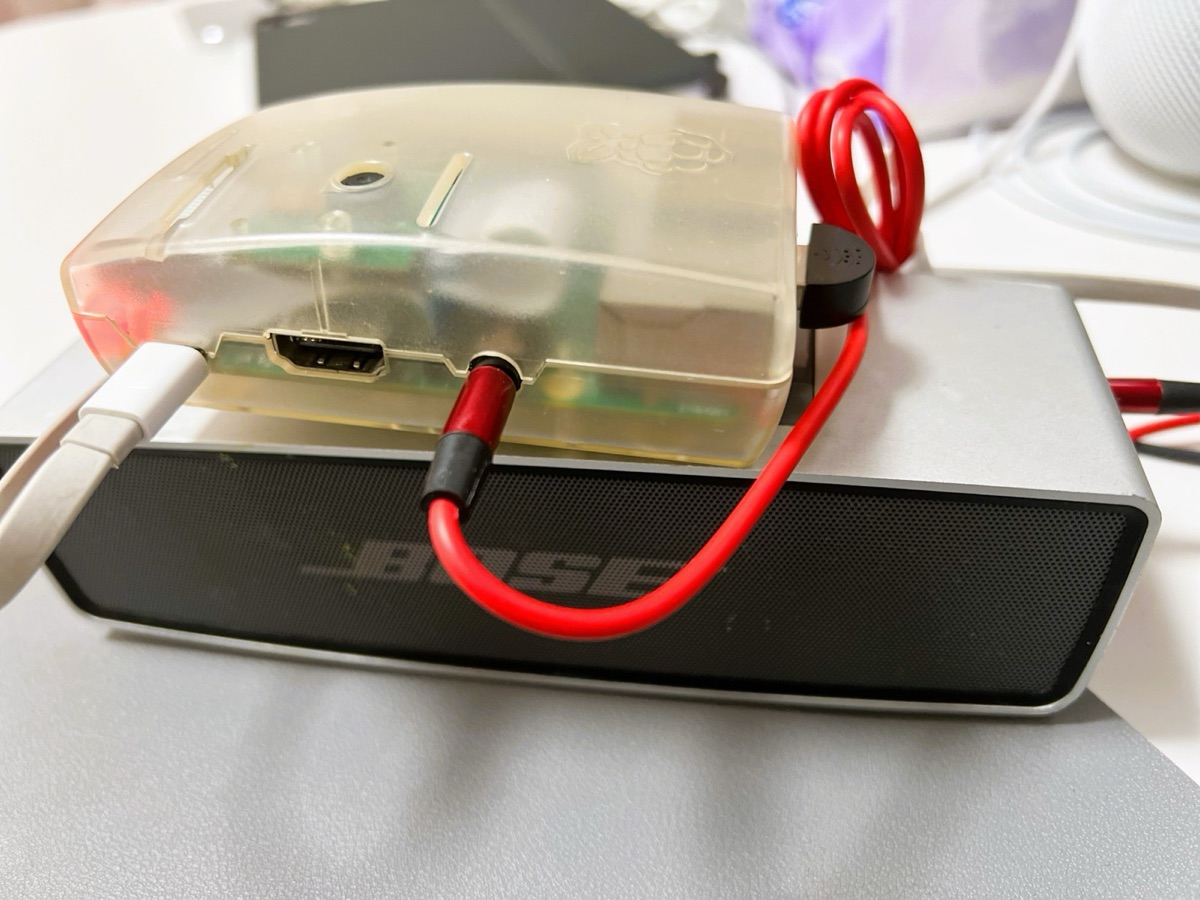
ChatGPT火了之后,每天都在网页上跟它聊天,但家里的Siri、小爱还是只能开灯关灯、查天气,稍微复杂一点的问题就答非所问。于是想着,能不能把ChatGPT装进音箱里,喊一声就能跟它对话?翻出吃灰的树莓派,接上一个USB麦克风和一台Bose音箱,折腾出了GPTSpeaker,代码已经开源在Github上。
功能
- 语音唤醒:本地识别唤醒词,像Siri一样喊一声就开始对话,默认唤醒词是”Hey GPT”,我自己的改成了”杰克同学”;
- 实时语音对话:ChatGPT/DeepSeek每返回一句话就马上合成语音播放,不用等整个回答生成完才开始说话;
- 连续对话:保存当前对话的历史,能接着上一句继续聊,对话超过指定的Token数时,自动丢弃最早的历史;
- 多种大模型:支持OpenAI官方API、Azure OpenAI,以及兼容OpenAI接口的DeepSeek(例如硅基流动);
- 跨平台:Python编写,支持Linux/Raspbian、macOS和Windows,没有树莓派用电脑也能跑。
演示视频
播放不了的话,可以到B站观看
硬件
- Raspberry Pi 3/3B/4/4B,一张至少8G的SD卡,安装Raspberry Pi OS (64-bit)或Ubuntu 22.04;
- USB麦克风,淘宝几十块钱就能买到;
- 带3.5mm音频口的音箱,我用的是家里的Bose SoundLink Mini。
云服务
- Azure AI Speech,负责唤醒词、语音转文字和文字转语音,免费层每月有5小时的音频额度,个人使用基本够了,区域建议选EastAsia或SoutheastAsia,国内访问比较快;
- 大模型三选一:
- OpenAI,创建API Key即可;
- Azure OpenAI,需要先申请访问权限,再部署模型;
- DeepSeek,官方API之前因为受到攻击一度不可用,可以用硅基流动的API,模型名填
deepseek-ai/DeepSeek-R1。
工作流程
整个对话流程是一个循环,每一轮大致如下:
- 麦克风持续监听,用本地的唤醒词模型检测唤醒词,这一步不需要联网;
- 检测到唤醒词后,调用Azure语音识别,把用户说的话转成文字,如果说的是”停止”,就结束对话;
- 把文字加入对话历史,以流式(stream)的方式发送给ChatGPT/DeepSeek;
- 一边接收大模型返回的内容,一边按标点符号切分成句子,放进队列;
- 另一个协程从队列里取出句子,调用Azure文字转语音,从音箱播放出来;
- 回答结束后,把完整的回答加入对话历史,回到第1步等待下一次唤醒。
实现要点
1. 本地唤醒词
唤醒词用的是Azure Speech SDK的KeywordRecognitionModel,模型是一个.table文件,识别在本地完成,不会一直把声音传到云端,也不产生费用。
- 代码库里自带了”Hey GPT”的模型
heygpt.table; - 如果想用自己的唤醒词,可以在Speech Studio里免费创建自定义关键字,下载模型后把
.table文件放到项目根目录,修改config.json里的WakePhraseModel和WakeWord即可。
2. 边生成边播放
如果等大模型把整段话生成完再合成语音,要干等好几秒,体验很差。所以这里用asyncio实现了一个生产者-消费者模型:
- 生产者:
ask_openai_async以stream=True请求大模型,逐块接收内容,遇到句末标点就把这一句放入asyncio.Queue; - 消费者:
text_to_speech_async不断从队列里取出句子,调用speak_text_async播放; - 生产者任务结束时,通过
add_done_callback往队列里放一个EOF,通知消费者退出。
核心代码如下:
1
2
3
4
5
6
7
8
9
10
11
async for chunk in response:
    if not chunk.choices:
        continue
    chunk_message = chunk.choices[0].delta.content
    if not chunk_message:
        continue
    collected_messages += chunk_message.replace('\n', ' ')
    if collected_messages.endswith(ending):  # 一句话结束
        await queue.put(collected_messages)
        full_answer += collected_messages
        collected_messages = ""
句末标点根据识别的语言来区分,中文用。?!;”,英文用. ? ! ;。另外,DeepSeek R1的思考过程放在reasoning_content里,content为空的片段会被跳过,所以音箱只会读出正式的回答,不会把一大段思考过程念出来。
3. 连续对话与Token截断
为了能连续对话,每一轮的问题和回答都会保存在conversation列表里,但对话越长,Token越多,迟早会超过模型的上下文限制。truncate_conversation用tiktoken计算Token数:
- 从最新的一条消息往前累加,超过
MaxTokens(预留100个Token的余量)就停止; - 保留最近的消息,丢弃最早的历史,最后原地更新
conversation列表。
4. 兼容多种大模型
OpenAI、DeepSeek和Azure OpenAI都用官方的openai库来调用:
- 配置了
OpenAI.Key时,创建openai.AsyncClient,如果配置了ApiBase,就把base_url指向DeepSeek等兼容OpenAI接口的服务; - 否则使用
openai.AsyncAzureOpenAI,填入Azure的Endpoint、api_version和部署名。
安装步骤
- 在Ubuntu或Debian上安装依赖的系统库,Ubuntu 22.04还需要额外安装
libssl1.1:1 2
sudo apt-get update sudo apt-get install libssl-dev libasound2
- 克隆代码并安装Python依赖:
1
2
3
 git clone https://github.com/jackwuwei/gptspeaker.git
 cd gptspeaker
 pip3 install -r requirements.txt
- 修改
config.json,填入Azure Speech的Key和Region,以及大模型的配置:1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
{ "AzureCognitiveServices": { "Key": "Azure Speech的Key", "Region": "eastasia", "SpeechRecognitionLanguage": "zh-CN", "SpeechSynthesisVoiceName": "zh-CN-XiaochenNeural", "WakePhraseModel": "heygpt.table", "WakeWord": "Hey GPT", "StopWord": "停止。" }, "OpenAI": { "Key": "OpenAI或者硅基流动的API Key", "Model": "deepseek-ai/DeepSeek-R1", "ApiBase": "https://api.siliconflow.cn/v1", "MaxTokens": 4096 } }
- 运行代码,喊一声唤醒词就可以开始聊天了:
1
 python3 gptspeaker.py
项目历程
- 2023年6月:完成第一版,实现唤醒词、语音识别、ChatGPT流式对话和语音合成;
- 2023年12月:适配openai 1.0版本的Python库;
- 2024年5月:支持Azure OpenAI;
- 2025年2月:支持DeepSeek R1;
- 2025年10月~12月:修复对话历史截断的Bug,整理单元测试,完善配置加载的错误处理。
后续
有了大模型之后,智能音箱终于不再是”人工智障”了。欢迎到Github上Star和提Issue,一起把它折腾得更好玩!
本文由作者按照 CC BY 4.0 进行授权